企業AIを前に進めるうえで、data lineage(データリネージ)の不明確さは「どの値がどこから来て、どこでどう変わったか」を追えなくする主要ボトルネックであり、規制対応・移行・分析/AI実装の速度と信頼を同時に落とす。
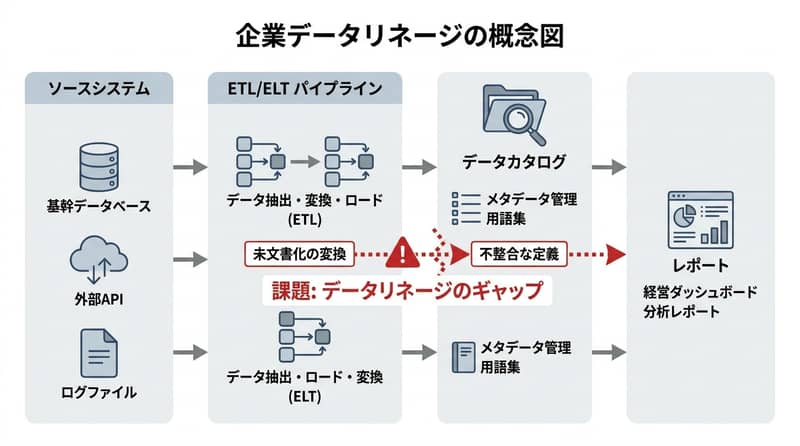
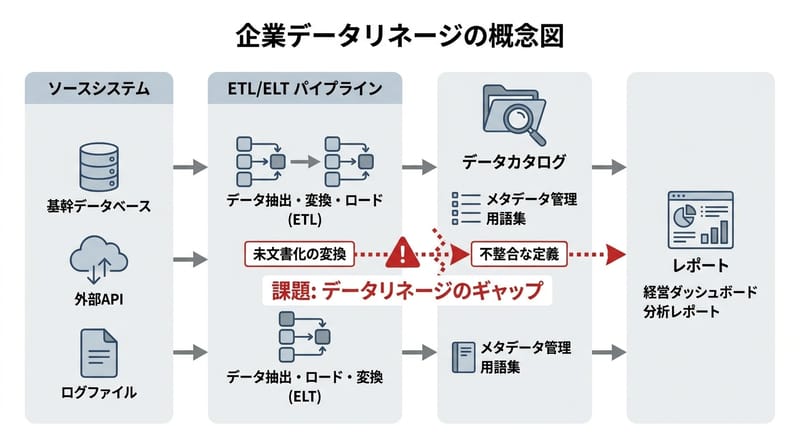
データ基盤って、最初から「複雑にしてやろう」と設計されることはrarelyです。けれど現実には、買収、新しいプラットフォーム導入、現場のローカルな回避策、レガシー統廃合(つなぐ・寄せる・捨てる、みたいな反復)で、じわじわ増築されていく。そのたびに、データの重複、未文書化の変換ロジック、定義の不一致が入り込みやすい。個々のデータセットの品質が高くても、値の出自や変化の履歴、どのバージョンをauthoritative(正)として扱うべきかが、チームとして分からなくなる——ここが痛い。
data lineageが「問題化」する典型パターン
data lineageとは、ある値がどこで生成され、どのシステムを通り、どんな変換(transformations)を受けて、最終的にレポートやダッシュボードに載るかという経路と根拠のことを指す。
問題の始まりは、わりと地味です。ドキュメントが不完全、そしてすぐ古くなる(frequently)。するとアナリストは、探す・突き合わせる・正しさを確認する、に時間を持っていかれる。disproportionateに。プロジェクトは止まり、データは再利用されず複製され、別チームが同じ関係性をまた調べる。これ、静かな浪費というより、毎回ちゃんと高い。
しかも、データの経路はETL/ELTの中だけに閉じていません。data catalogs、メタデータ、個別のスクリプト、DAGs、そして最後は「誰かの記憶」。知識が散るほど、追跡は長期戦になります。
規制対応は「理論」から財務インパクトへ移った
Since 2020、banking、financial services、healthcareの組織は、deficient monitoring and reporting frameworks(不十分な監視・報告フレームワーク)などを背景に、BCBS 239のような基準未達を含む理由で、確定したregulatory penalties(規制上の罰金)として合計$1.4 billion超を支払っている。
ここでやや誤解されやすいのが、「リネージが無い=罰金」と短絡しがちな点。原文のニュアンスはもう少し限定的で、often due to(しばしば〜が原因で)という形です。つまり、規制上の要求を満たすうえで必要なモニタリング/報告の枠組みが弱く、その中でリネージを追えないことが実務的な障害になっている、という話。
複雑なデータ環境だと、単一要素をsourceからreportまで辿るだけで数週間かかり得る。理由は単純で、関連知識がETLツール、data catalogs、そして個人の記憶に散らばっているからです。散ってる。ほんとに散ってる。
さらに、未解決のリネージは、規制順守だけでなく、レガシーデータ基盤(legacy data estate)近代化で得られるはずのコスト削減も阻む、と位置づけられています。基礎コストのスケールが大きい。大規模機関では、データソース調達とdata governance維持が総IT支出のroughly a fifthを占め得て、そのうちmore than halfがdata controlsとmanual governance activityに向かう、という整理です。
この前提があるから、リネージ改善で追跡・検証・是正(trace, validate, remediate)に要する労力を減らせれば、推定で$30 million to $100 millionのコスト削減を実現できるmay be able to、というレンジが出てくる。推定で、可能性。断定じゃない。
手作業のリネージが限界に当たる理由(ポイントソリューション問題)
多くの企業はいまだに、最重要データのリネージを手作業に依存しており、その割合はup to three-quartersに達し得る。手作業でend-to-end(E2E)に追うほど、遅く、そして高価になる。
背景にあるのは、現行のリネージツールが「単一システム内の移動」を追うpoint solutionsになりがち、という制約です。point solutionsというのは、ある一点の問題(たとえば特定プラットフォーム内のトレース)には強い一方で、企業全体のような跨システム・跨世代のつながりを一枚の地図として扱うのは苦手、という意味合いで使われています。
エンタープライズのdata estateは、数十のシステムで構成されるのがnot unusual。しかも、それらは何年、時には何十年も前に構築され、legacy platformsや複数のプログラミング言語の上にあり、ロジックが未文書化のまま残っている。こうなると、手で辿る以外に道がない場面が出てくる。
そしてコスト。レガシーとクラウドを跨いで、単一のデータ要素をE2Eで手作業トレースするのは、direct costとしてtypically one to three million dollars。要素1つで、です。ちょっと静かに怖い数字。
AI4DLが狙う位置:既存ツールの置き換えではなく「ギャップの補完」
QuantumBlack, AI by McKinseyのAI4DL(AI for data lineage)は、コード・metadata・生データを合わせて解釈し、環境やプラットフォームを跨ぐ接続を検出することで、手作業中心のリネージ作成を加速し、既存のリネージツール間のギャップを埋めることを目的とする。
ここは、マーケ文脈だと誤読されやすいので、編集的に一度整えておきます。AI4DLは「すべてを置き換える」前提ではなく、既存ツールがカバーしにくい部分(跨システム、古いコード、散った知識)を補う位置づけです。can complement。補完。
それと、AIの進展(past yearの進展として言及されている範囲)により、コードとmetadataを生データと並べて解釈できるようになった、というのが技術側の前提。つまり「どこに何が書いてあるか」を人間が探す前に、機械が横断的に当たりを付けられるようになってきた、という話です。
AI検出+人手検証:audit-gradeを目指すための設計
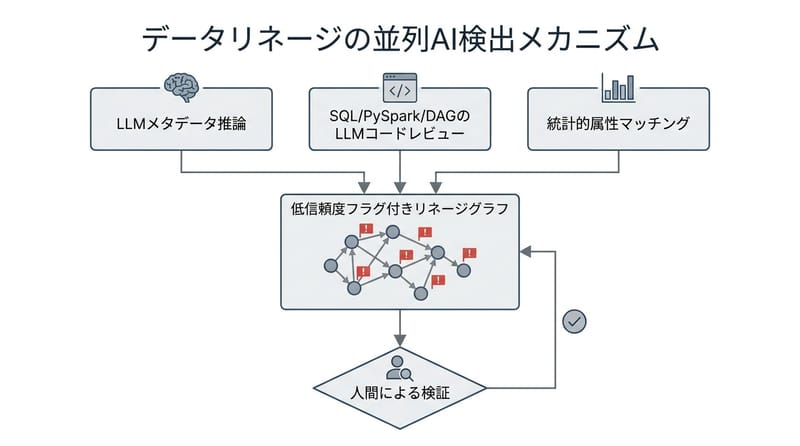
AI4DLは、複数の検出(detection)手法を並列に走らせ、低信頼(low confidence)の判断をフラグし、人間の専門家がlineage graphをレビューして不整合を事前に潰すことで、方向性(directional)ではなくaudit-grade(監査対応レベル)の成果物に近づける。
検出のシグナルは、ざっくり三系統に分かれています。で、こういう箇条書きは読み飛ばされがちなんだけど、ここは骨格なので残します。
- LLM-based metadata inference:data catalogsの情報(テーブル/カラム名、説明、制約、タグ、オーナー)を読み、あり得そうなリネージを推定する。
- LLM-based code review:SQL、PySpark、DAGsなどのETL/ELTコードを解析し、column-level lineageを導出し、各変換が実際に何をしているかを要約する。
- Statistical attribute matching:data profilingやdistribution similarity(分布の近さ)を使い、異なるデータセット間のカラム類似性を提案する。
重要なのは「どれか一発で当てる」ではなく、並列に走らせること、そして結果を鵜呑みにしないこと。not taken at face value。低信頼のところを機械が自覚して、人が見る。地味だけど、規制産業ではここが効く。
スケールの話も出ています。単一のCOBOLプログラムに対して使うアプローチを、two thousand以上に拡張しても、同程度の正確性と信頼を保てる、という主張です。もちろん「同程度」の定義は本文では定量化されていないので、ここはそのままの粒度で受け取るべきところ。
4つの代表ユースケース:同じリネージ成果物を使い回せるか
AI4DLは、さまざまなシステム/技術が混在する環境でもend-to-endのリネージを特定し、再利用可能なlineage outputを作るアクセラレータとして説明されている。価値はユースケースごとに現れ方が違うが、共通項は「手作業の調査・文書化・検証の削減」による生産性だ。
- Regulatory traceability:コンプライアンスチームが、データの流れ・変換・依存関係を最新に近い形で可視化できる、という整理。
- Improved data and business understanding:起源、依存、変換、消費パターン(consumption patterns)を横断的に露出させる。
- Migration readiness:レガシーとモダンのデータモデル間のマッピングを加速し、platform and code migrationsの工数を削る。
- AI and analytics implementation:AI agentsが企業データを見つけ、解釈し、使うための「検証済みコンテキスト」を与える。
この「同じlineage graphを、規制側・移行側・データエンジニアリング側が参照し、別々の(しかも不完全になりがちな)真実の写しを持たなくて済む」という点が、信頼(trust)の話の芯です。信頼って言うとふわっとするけど、要するに「同じ根拠の地図を見て議論できる」状態。
AI agentsの話も、ここに繋がります。クリーンなリネージがあると、AI agentsがデータをソースするときのガイドになり、効率と有効性が上がり得る。さらに、経営層が既存のダッシュボード、そしてこれから頼ることになるエージェントに対して、genuine trustを持ちやすくなる、という論理です。mayのまま。
事例で見る「速さ」以外の差:監査できる道筋が残る
以下は、本文に挙がっている3つの例です。ここでは数字が多いので、「何が一般論で、何が個別事例か」を崩さないように並べます。数字はそのまま。
Example(Latin American bank):AI-first戦略を進めるmajor Latin American bankが、data quality問題で足止めされていた。対象はten years分のreal-timeのクレジットカードおよび投資データで、more than 34 billion rows、2,000-plusのCOBOLプログラムと50-plusのDB2テーブルに分散していた。metadataとコードを分解してend-to-endリネージにし、その上にAIモデルを重ねることで、リネージ作成時間をten weeksからa few hoursへ短縮し、data governanceとエンジニアリングチーム合算でroughly 50,000時間を解放した、とされる。
Example(European insurer):European insurerのDatabricks migrationが、more than 100のlegacy SQL scriptsに関するドキュメント不足と、理解者の退職で停滞していた。AI4DLがスクリプトを解析し依存関係を追跡、手作業で作られたリネージと照合して検証し、about 98 percentの精度に到達した、と記載されている。ここは「about」付き。精度の定義(何を正解とするか)は本文の範囲ではそれ以上踏み込んでいません。
Example(European bank):European bankのデータ移行で、当初見積もりがfive peopleがone yearフルタイム。AI4DLでtarget featuresのabout halfを自動マッピングし、元のベースラインに対して65 percentの効率向上が得られた、という整理。最終的にsource-to-target mappingsの70 percentが正しかった。確認作業はsubject-matter expertがone monthの間、a quarter程度の稼働で行った、とされる。ここ、数字が多いけど「自動化で半分をマップ」「正解は70%」「確認は1か月・稼働1/4」という並びが核です。
3例に共通する結論は、「速くなった」だけではない、という点。関係者(銀行、保険会社、規制側を含む)が、レポート上の数値がソースにどう繋がるかを、特定可能で監査できるtrailとして指し示せるようになった。以前はそれが自信をもってできなかった、と締めています。
AI4DLは再構築を要求しない:導入形態と到達点
AI4DLは、mainframe、on-premises、cloudといったsource systems全体に跨って動作し、技術スタックのrebuildを要求せずに実装できる。展開はcloud-native、hybrid、on-premisesのいずれも取り得て、既存アーキテクチャに合わせて拡張可能だとされる。
成果として目指すのは、フィールドがどう導出され(derived)、変換され(transformed)、消費される(consumed)かを辿れる「一つの統合マップ」。システムごと・レイヤーごとに分断されたドキュメントの寄せ集めではなく、という対比です。で、ここが結構現実的で、ドキュメントを増やすと管理が増えるだけ、みたいな事故が起きがちなので。
始め方:単一ユースケースのパイロット→レシピ化→反復でスケール
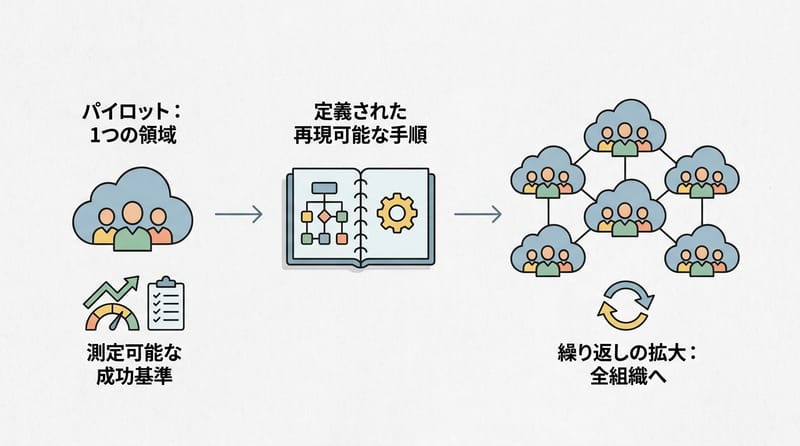
推奨されている開始方法は、単一ドメインまたは単一プロダクトに絞ったパイロットで価値を検証し、測定可能な成功条件のもとでアプローチを洗練し、それを繰り返し可能なレシピにしてから全社へスケールする、という手順である。
入口(最初のユースケース)は、経済性が最も明確なところが良い、という言い方をしています。例としては、規制レポート、難しいデータドメイン、migration wave、あるいはbounded agent workflow。boundedという言葉が入っているのがポイントで、エージェント活用も「無制限に広げる」より、範囲を区切ったワークフローで測れる形にする、という含意です(ここも本文の言い換えの範囲)。
レシピが機能し始めると、AI-driven lineageの全社展開は「発明」ではなく「反復」になる。原文のこの言い回しは、わりと芯を食っている。毎回違う正義を作らない、ってことなので。
AI4Dataポートフォリオへの言及(本文の主筋から外しすぎない範囲で)
本文の主役はAI4DLですが、末尾ではAI4Data(QuantumBlack, AI by McKinsey)のより広いポートフォリオにも触れています。ここは宣伝色が強くなりやすい箇所なので、事実関係だけ残して短く整理します。
- AI4Data Quality:カスタマイズ可能なAIベースのツールキットでデータ品質問題を検出・修正する、と説明されている。
- AI4Data Quality Unstructured:AI4DQの拡張として、非構造データセットの問題検出・修正を扱う、とされる。
- AI4Data Products:テーブルスキーマからETL/ELTコードを自動生成し、エンジニアリング時間をup to 80 percent削減し得て、生成パイプラインにbest practicesを埋め込む、という位置づけ。
- AI4Data Extraction:PDF、PPTs、PNGsのような非構造ドキュメントを、agentic workflows下流で再利用可能な構造化データ資産へ変換する、と説明されている。
このポートフォリオは、これまでclientsとmore than 100 timesデプロイされてきた、とだけ述べられています。どの業界・どの範囲で、という内訳は本文にはありません。なので、ここはここまで。
結論:リネージが「一回限りの調査」から日常インフラになる条件
AI4DLは、data lineageを速く作って再利用できる成果物にし、規制報告・データ移行・AI/分析ユースケースに共通する手作業を減らすことで、企業AIの進展を阻むボトルネックを緩めることを狙っている。
リネージが遅く手作業のままだと、毎回その場しのぎの一回戦になる。逆に、作成が速くなり、検証され、使い回せる形になると、日々の意思決定や実装を支えるインフラに寄っていく。本文が言っているのは、だいたいそこです。派手さはない。でも効く。